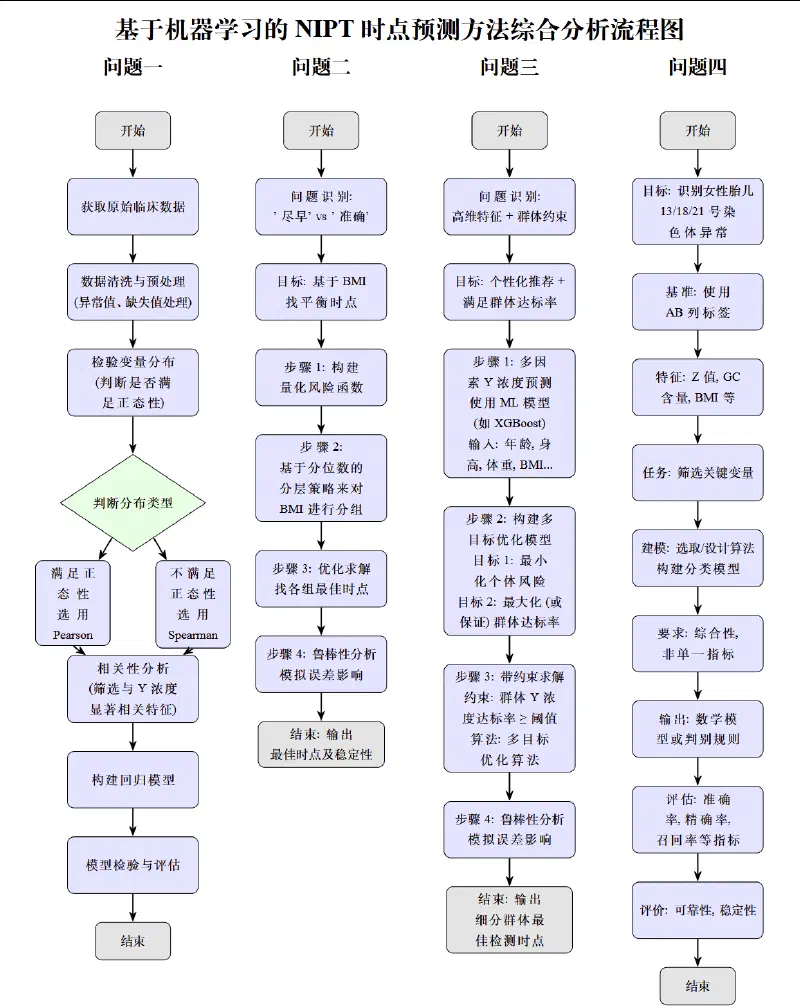
研究背景#
NIPT(无创产前检测)通过分析孕妇外周血中的胎儿游离 DNA,对胎儿常见染色体非整倍体异常进行筛查。
在实际检测过程中,胎儿游离 DNA 浓度会受到孕周、孕妇 BMI、年龄等多种因素影响。若检测时间过早,胎儿 DNA 浓度可能不足,导致检测失败或结果可靠性下降;若检测时间过晚,又可能错过更合适的检测与干预窗口。
因此,传统固定检测窗口的“一体适用”方案难以充分考虑孕妇之间的个体差异。
本研究围绕这一问题,希望从统一检测时间转向基于个体特征的数据驱动推荐,构建一套覆盖:
影响因素分析 → 浓度预测 → 检测时点优化 → 多因素联合决策 → 染色体异常识别
的 NIPT 个性化建模体系。
研究目标#
研究主要围绕四个相互关联的问题展开。
Y 染色体浓度影响因素分析#
分析检测孕周、BMI、年龄、身高、体重、染色体相关指标以及测序质量指标等因素与男胎 Y 染色体浓度之间的关系,并建立能够描述复杂非线性关系的预测模型。
基于 BMI 的检测时点推荐#
根据孕妇 BMI 对人群进行分层,在“尽早完成检测”和“保证胎儿 DNA 浓度达到检测要求”之间进行权衡,为不同 BMI 群体寻找综合风险较低的检测时点。
多因素个性化优化#
在 BMI 分层基础上进一步考虑时间、准确性、成本及分组差异等风险因素,同时优化:
- BMI 分组边界;
- 各组最佳检测孕周。
目标是降低整体潜在风险,使分组与检测时点推荐更加数据驱动。
女胎染色体异常识别#
对于无法利用 Y 染色体作为直接指标的女胎样本,综合染色体 Z 值、GC 含量、BMI、年龄和测序相关指标建立二分类模型,对 13、18、21 号染色体非整倍体异常进行风险识别。
整体研究框架#
整个研究形成了如下递进链路:
数据预处理 → 特征相关性分析 → XGBoost 非线性建模 → BMI 分层风险优化 → 多因素联合优化 → 女胎异常分类与阈值优化
主要使用的方法包括:
Shapiro-Wilk Spearman XGBoost SHAP Grid Search Monte Carlo Simulation Differential Evolution SMOTE LightGBM Precision-Recall
数据预处理#
由于数据来源于真实检测记录,在正式建模前首先对数据进行了清洗和标准化处理。
样本筛选#
针对不同研究任务分别筛选男胎和女胎样本,并保留后续模型所需要的关键检测记录。
孕周格式转换#
将类似:
13w + 5
的孕周表示转换为连续数值:
13 + 5 / 7 ≈ 13.71
便于进行机器学习建模和数值优化。
缺失值与异常值处理#
对 BMI、孕周等关键变量的缺失情况进行检查,并结合数据特征完成相应的数据补全和异常记录处理。
重复检测处理#
对于同一孕妇在同一日期或相同孕周存在多次检测的情况,对重复记录进行筛选,尽量避免重复样本对模型训练产生额外影响。
Y 染色体浓度影响因素建模#
数据分布与相关性分析#
首先结合变量分布直方图、Q-Q 图和 Shapiro-Wilk 检验分析核心变量的分布特征。
结果表明,BMI、检测孕周、Y 染色体浓度等变量大多不满足正态分布假设,因此采用非参数的 Spearman 等级相关系数分析变量之间的单调关系。
分析得到:
- Y 染色体浓度与孕妇 BMI 呈负相关,Spearman ρ 约为
-0.152; - Y 染色体浓度与检测孕周呈弱正相关,ρ 约为
0.087。
结果表明:
BMI 越高,Y 染色体浓度总体越低;随着孕周增加,Y 染色体浓度总体呈上升趋势。
但整体相关程度并不高,说明这些变量与 Y 染色体浓度之间并不是简单线性关系。
XGBoost 非线性回归#
为进一步捕捉变量之间的复杂非线性关系,研究采用 XGBoost 回归模型预测 Y 染色体浓度。
模型首先使用候选变量进行训练,并根据特征重要性筛选关键特征,最终重点考虑:
- 检测孕周;
- 孕妇 BMI;
- X 染色体浓度。
同时针对目标变量的偏态分布进行相应变换,以改善模型训练效果。
五折交叉验证#
采用 5 折交叉验证评估模型稳定性。
五折 R² 分别约为:
0.5960、0.4698、0.5777、0.5926、0.5315
最终得到:
平均 R² = 0.5535
标准差 = 0.0478
模型能够解释超过一半的 Y 染色体浓度变化,同时不同数据划分下的性能波动相对有限。
SHAP 可解释性分析#
为了降低机器学习模型的“黑箱”属性,进一步利用 SHAP 分析各特征对预测结果的影响。
结果显示:
- X 染色体浓度:与预测的 Y 染色体浓度存在明显正向关系;
- 检测孕周:总体表现为弱正向影响;
- 孕妇 BMI:表现出较明显的负向影响。
因此,XGBoost 不仅能够学习复杂非线性关系,也能够通过 SHAP 对主要预测因素进行解释。
基于 BMI 分层的检测时点优化#
在问题一的浓度预测模型基础上,进一步研究:
不同 BMI 孕妇应该在什么时候进行 NIPT 检测?
其中存在一个核心权衡:
检测过早可能导致胎儿 DNA 浓度不足,而检测过晚又会增加时间成本和潜在风险。
因此,将检测时点选择转化为综合风险最小化问题。
BMI 分层#
采用基于分位数的分组方法,将样本划分为三个 BMI 群体。
低 BMI 组
- BMI:
20.70 ~ 30.65 - 样本量约:
336 - 平均 BMI:
29.4
中 BMI 组
- BMI:
30.66 ~ 33.18 - 样本量约:
333 - 平均 BMI:
31.9
高 BMI 组
- BMI:
33.20 ~ 46.88 - 样本量约:
339 - 平均 BMI:
35.5
该分组方式使各组样本规模相对接近,同时保证 BMI 区间连续且基本不重叠。
风险最小化模型#
研究主要考虑两类风险。
时间效率风险
用于描述检测时间过早或过晚所产生的时间成本与延误风险。
浓度不达标风险
用于描述某一孕周下胎儿 DNA 浓度未达到检测要求的可能性。
综合风险可以概括为:
综合风险 = 时间效率风险 + 浓度不达标风险
针对不同候选孕周,利用 XGBoost 模型预测 Y 染色体浓度,并计算相应风险,从中寻找综合风险最低的位置。
最佳检测时点#
最终得到:
- 低 BMI 组:14.2 周
- 中 BMI 组:18.2 周
- 高 BMI 组:25.2 周
整体呈现明显趋势:
BMI 越高,推荐检测时点越晚。
这一结果说明,固定使用统一检测窗口可能无法充分适应不同 BMI 群体之间的差异。
蒙特卡洛鲁棒性分析#
为了分析预测误差是否会显著改变最佳检测时间,在 XGBoost 预测结果中加入随机扰动。
模拟设置包括:
- 预测误差标准差约
0.5%; - 每个群体重复模拟
50次; - 每次重新计算最佳检测时点。
结果显示,中低 BMI 群体推荐时间较为稳定,高 BMI 群体虽然存在一定波动,但最优时点总体仍集中在相对有限的范围内。
说明该分层推荐策略具有一定鲁棒性。
多因素分组与检测时点联合优化#
固定 BMI 分组本身仍然带有一定人为设定。
因此进一步将:
BMI 分割点本身也作为优化变量
让算法同时决定:
- 如何划分 BMI 群体;
- 各群体应在什么孕周进行检测。
决策变量#
模型需要同时搜索五个变量:
V = (s1, s2, t1, t2, t3)
其中:
s1:第一个 BMI 分割点;s2:第二个 BMI 分割点;t1:低 BMI 组检测时间;t2:中 BMI 组检测时间;t3:高 BMI 组检测时间。
多因素风险函数#
相比前一阶段,联合优化模型进一步考虑:
时间风险
描述检测过早或过晚导致的时间损失。
准确性风险
根据 XGBoost 预测结果计算浓度不达标概率。
检测成本风险
刻画不同检测时间对应的潜在成本差异。
孕妇风险
根据 BMI 水平对相关风险进行简化量化。
分组差异惩罚
避免出现低 BMI 人群检测过晚、高 BMI 人群检测过早等不合理组合。
最终对这些风险项进行加权,构成整体目标函数。
差分进化优化#
由于目标函数同时具有非线性、非凸、分段函数以及连续和离散变量混合等特点,因此采用 Differential Evolution(差分进化)进行全局搜索。
算法不断生成不同的:
(s1, s2, t1, t2, t3)
组合,并计算相应总风险,最终寻找整体风险较低的方案。
最优方案#
最终得到两个 BMI 分割点:
23.89
31.98
对应三组推荐策略为:
低 BMI 组
- BMI:
[20.70, 23.89) - 推荐:第 12 周检测
中 BMI 组
- BMI:
[23.89, 31.98) - 推荐:第 14 周检测
高 BMI 组
- BMI:
[31.98, 46.88] - 推荐:第 15 周检测
对应理论最小总风险:
0.7551
整体仍然呈现 BMI 越高、推荐检测时间越晚的阶梯式变化。
误差敏感性分析#
进一步在不同噪声水平下重复优化,以分析数据误差对最终方案的影响。
结果表明:
- 低噪声环境下模型具有较好的稳定性;
- 当噪声不超过约
10%时,整体优化结果仍相对稳定; - 随着噪声增大,风险评估不确定性明显增加;
- 高噪声下,BMI 分割点和最佳检测孕周容易出现波动。
因此,这类个性化推荐模型对临床数据质量具有较高依赖。
女胎染色体异常识别#
对于女胎样本,由于不存在 Y 染色体,无法直接利用 Y 染色体浓度作为判断指标。
因此,将女胎异常识别建模为二分类问题,根据多维检测特征判断样本属于:
正常 / 异常
其中异常标签依据 13、18、21 号染色体非整倍体检测结果确定。
类别不平衡处理#
原始训练集中:
- 正常样本:
478 - 异常样本:
64
异常样本仅占约:
11.8%
直接训练容易使模型明显偏向数量更多的正常类别。
因此采用 SMOTE 对异常样本进行合成过采样。
处理后:
- 正常样本:
478 - 异常样本:
478
从而形成相对平衡的训练数据。
LightGBM 分类模型#
研究使用 LightGBM 建立女胎异常分类模型。
输入特征主要包括:
- 孕妇年龄;
- BMI;
- 各染色体 Z 值;
- GC 含量;
- X 染色体相关指标;
- 测序读段数;
- 比对比例;
- 其他相关生物信息学特征。
数据按照约 7 : 3 划分训练集和测试集,并采用分层抽样保持正常和异常样本比例。
超参数优化#
采用网格搜索与分层交叉验证优化模型参数,重点调整:
- 学习率;
- 树深度;
- 叶子节点数量;
- 估计器数量;
- 子采样比例;
- 特征采样比例;
- 正则化参数。
由于异常识别属于典型类别不平衡任务,因此评价时不仅关注 Accuracy,更关注:
Precision Recall F1 Score
默认模型结果#
在默认分类阈值下:
正常类别
- Precision:
0.91 - Recall:
0.93 - F1:
0.92
异常类别
- Precision:
0.46 - Recall:
0.40 - F1:
0.43
整体 Accuracy:
0.86
虽然总体准确率较高,但异常类别召回率仅为 40%。
换言之,15 个真实异常样本中只能识别出约 6 个。
这说明仅使用整体 Accuracy 评价模型,会掩盖模型对少数异常类别识别能力不足的问题。
Precision-Recall 阈值优化#
在筛查任务中,相比误报,漏掉真实异常样本通常需要更加谨慎。
因此进一步分析 Precision-Recall Curve,并降低分类决策阈值,提高模型对异常样本的敏感程度。
优化后:
异常 Recall:0.40 → 0.80
也就是说模型能够识别约:
80% 的真实异常样本
与此同时,异常类别 Precision 降低至约:
0.23
体现出明显的 Precision 与 Recall 权衡。
因此,该模型更适合作为高敏感度的初步风险筛查工具,而不是直接作为最终诊断依据。
核心结果#
本研究最终形成了从数据分析、预测建模到风险优化和异常识别的一整套建模流程。
Y 染色体浓度预测#
XGBoost 五折交叉验证:
平均 R² = 0.5535
标准差 = 0.0478
BMI 分层检测时点#
基于风险最小化模型:
- 低 BMI:14.2 周
- 中 BMI:18.2 周
- 高 BMI:25.2 周
多因素联合优化#
得到 BMI 分割点:
23.89 / 31.98
对应推荐孕周:
12 周 / 14 周 / 15 周
理论总风险:
0.7551
女胎异常识别#
LightGBM 经阈值优化后:
异常 Recall:40% → 80%
研究特点#
从统计相关性扩展到非线性建模#
研究没有停留在简单相关系数分析,而是进一步使用 XGBoost 学习孕周、BMI 等因素与 Y 染色体浓度之间的复杂非线性关系。
引入模型可解释性#
通过 SHAP 分析不同变量对预测结果的贡献方向,使模型不仅能够给出预测结果,也能够解释主要影响因素。
从预测进一步走向决策#
研究并不只关注“浓度能否预测”,而是进一步回答:
什么时候检测更合适?
通过风险函数将机器学习预测结果转化为检测时点优化问题。
自动优化人群分组#
进一步将 BMI 分割点也纳入决策变量,通过差分进化同时优化:
人群分组 + 检测时点
降低固定分组规则带来的主观性。
关注少数异常样本#
在女胎异常识别中,通过 SMOTE、Precision-Recall 分析和阈值优化,重点提升模型对少数异常类别的召回能力。
使用鲁棒性分析验证方案#
通过随机扰动与重复模拟,进一步检验预测误差和数据噪声对最终推荐结果的影响。
模型局限#
对数据质量依赖较强#
模型训练、BMI 分组边界和检测时点推荐均直接依赖当前数据。
当实际人群的 BMI 分布、年龄结构、检测设备或实验流程发生变化时,模型性能可能随之变化。
风险函数包含人为设定#
时间风险、成本风险、权重和分组惩罚等因素均需要进行数学化定义,因此仍然是对真实临床决策过程的简化。
高噪声环境下稳定性下降#
误差分析表明,随着输入误差增大:
- 最优 BMI 分组更容易变化;
- 推荐孕周波动增加;
- 总风险估计不确定性上升。
因此模型需要建立在较严格的数据质量控制基础上。
外部泛化能力仍需验证#
当前结果主要基于已有数据完成训练和测试,在不同地区、医疗机构、人群和检测平台上的泛化能力仍需通过更多独立数据验证。
Precision 与 Recall 存在明显权衡#
异常 Recall 提高到 80% 后,Precision 降低到约 23%。
因此模型更适合作为:
高敏感度的初步风险筛查模型
而不是独立承担最终临床诊断。
总结#
本研究围绕 NIPT 检测中的个体差异和异常样本识别问题,构建了一套从统计分析、机器学习预测到风险优化与异常分类的完整数据驱动模型体系。
在男胎分析中,研究利用 Spearman 分析变量关联,通过 XGBoost 建立 Y 染色体浓度非线性预测模型,并结合 SHAP 分析模型可解释性。在此基础上,进一步构建基于 BMI 的风险最小化模型,并使用差分进化联合优化 BMI 分组边界与检测孕周,同时通过蒙特卡洛模拟和误差敏感性分析检验方案稳定性。
在女胎异常识别中,将任务转化为类别不平衡二分类问题,通过 SMOTE 平衡样本、LightGBM 完成分类,并结合 Precision-Recall 曲线进行决策阈值优化,将异常样本召回率由 40% 提升至 80%。
最终形成:
数据分析 → 非线性预测 → 风险量化 → 分组优化 → 检测时点推荐 → 异常识别
的完整建模链路。
相比固定检测时间的“一体适用”方式,本研究尝试利用个体特征与数据模型,为不同孕妇群体提供更加差异化的检测时点建议,并为 NIPT 个性化检测方案的进一步研究提供数据驱动的建模思路。
关键词#
NIPT XGBoost LightGBM SHAP SMOTE 差分进化 蒙特卡洛模拟 风险优化 机器学习 医疗数据分析